开发工具
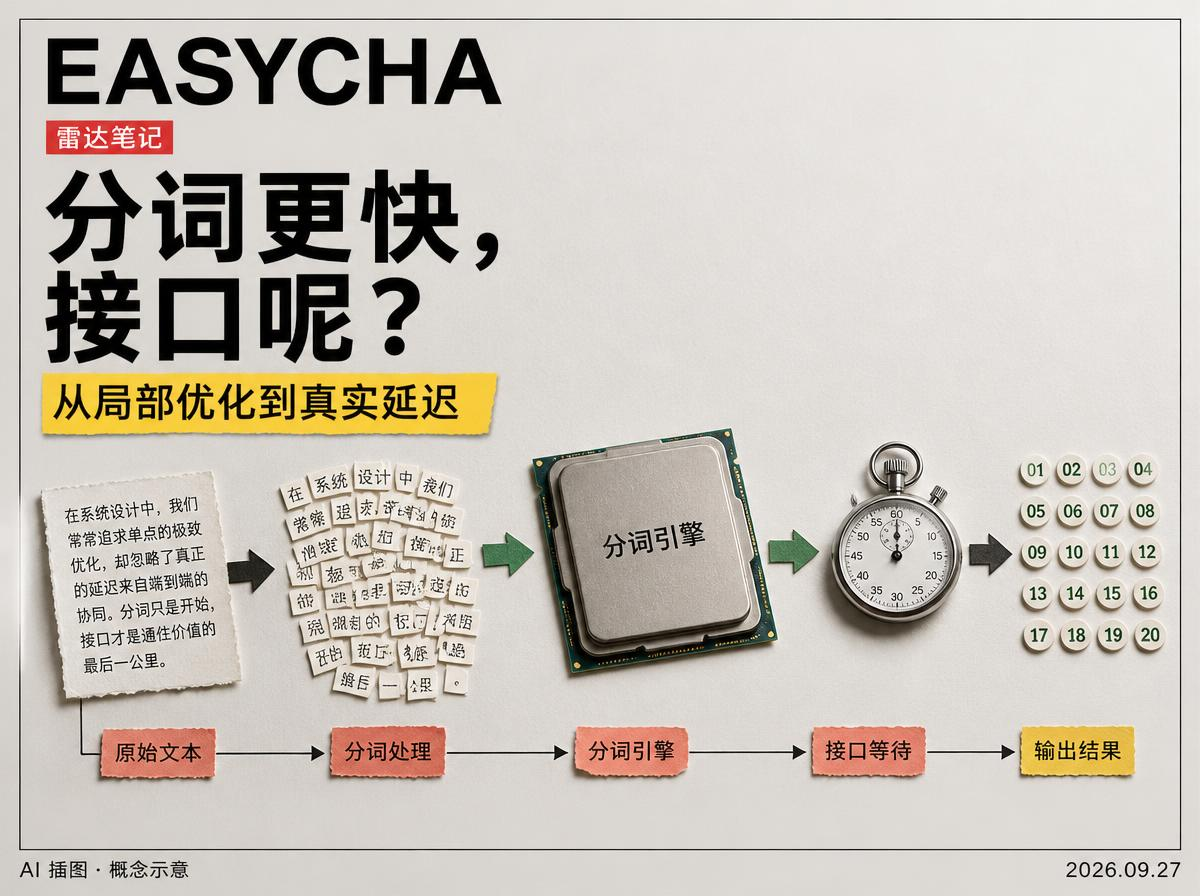
分词更快,AI 接口就更快吗?读懂 Tokenizers v1 的升级边界
Easycha 编辑部
#Hugging Face#Tokenizers#推理优化
一周观察|事件日期:2026 年 9 月 21 日
当模型不断加快输出,输入端一个常被忽略的环节也开始值得关注:分词。Hugging Face 在 9 月 21 日的官方文章中介绍了 Tokenizers v1 候选版本的性能工作。它优化的是把文字转换成模型可读取的整数序列,以及相关编码、解码流程。本文依据官方公开材料进行分析,Easycha 未独立复现其中的基准测试。
官方披露:目标是更快处理,而非改变答案
原文强调,v1 的目标是保留 v0.23 的输出、接口、词表与合并优先级,生成相同的 token ID。改动集中在计算过程:对能够识别的分词规则采用更高效的拆分路径,用线程本地缓存复用重复片段的结果,并重复使用临时缓冲区,减少内存分配。多线程编码也经过调整,降低共享锁带来的排队。
这些细节有实际含义。同一个短语反复出现时,缓存可能减少重复计算;遇到很少重复的新片段,缓存收益就可能下降。原文也指出,不在已识别规则范围内的分词器仍会使用正则表达式路径,不能把某一类输入的提升套用到所有模型。
性能数字应连同条件一起读
官方报告称,在 Apple M4 Max 上,覆盖十个模型家族的单线程编码测试,相比 v0.23 获得约 3 至 30 倍的速度提升。这个范围描述的是指定条件下的分词编码环节。原文说明,主要结果使用不同文档,完整语料大于缓存容量;词表加载另行计时,并校验输出 ID 是否与基线一致。
另一个容易忽视的边界是语言绑定。这些测试针对 Rust crate,未计入 Python 绑定的每次调用开销。反复编码同一份文档,与持续处理不同文档,也不是同一种缓存条件。因此,引用性能数字时,应同时保留硬件、输入分布、线程数和调用方式,避免把局部测试理解成整条服务链路的承诺。
Easycha 分析:先确认慢在哪里
对自建推理服务的团队,这项更新更适合被视为排查 CPU 输入处理瓶颈的新选项。如果长文本预处理或并发分词已经让模型等待,优化它可能释放吞吐量;如果主要时间花在网络、排队、模型预填充或逐字生成上,分词提速对用户等待时间的影响可能有限。局部环节即使明显加速,也不会自动带来同倍数的首字提速。
对使用托管 API 的开发者,本地升级一个库也不能替服务商升级其后端。对于采用相同分词器与配置的输入,保持相同 token ID 意味着编码优化本身并不压缩 token 数量;不能据此推导某家 API 会降价,或同一请求的账单必然减少。
落地建议:用自己的输入验证
原文提供的是 Rust 预发布安装方式,并把更多模型支持、Python 绑定简化等列入后续工作。团队试用前应确认所用语言、包版本与依赖是否已经包含相关改进,尤其不要把候选版本理解为所有生态组件都已完成迁移。
Easycha 建议挑选真实业务中的中文长文、代码、重复前缀和少重复输入,分别记录冷启动、批量处理、并发与端到端延迟,并检查输出 ID 的一致性。对这次更新最有价值的判断,不是追逐最大的倍数,而是确认它是否改善了自己系统里正在阻塞的那一步。
来源与延伸阅读
- Hugging Face:tokenizers v1: encode, decode and scaling, measured
来源发布日期:2026-09-21