模型与结构化数据
NVIDIA 发布 Kumo Tabular:表格预测也能用上上下文学习
Easycha 编辑部
#NVIDIA#Kumo Tabular#表格预测
事件日期:2026 年 9 月 29 日
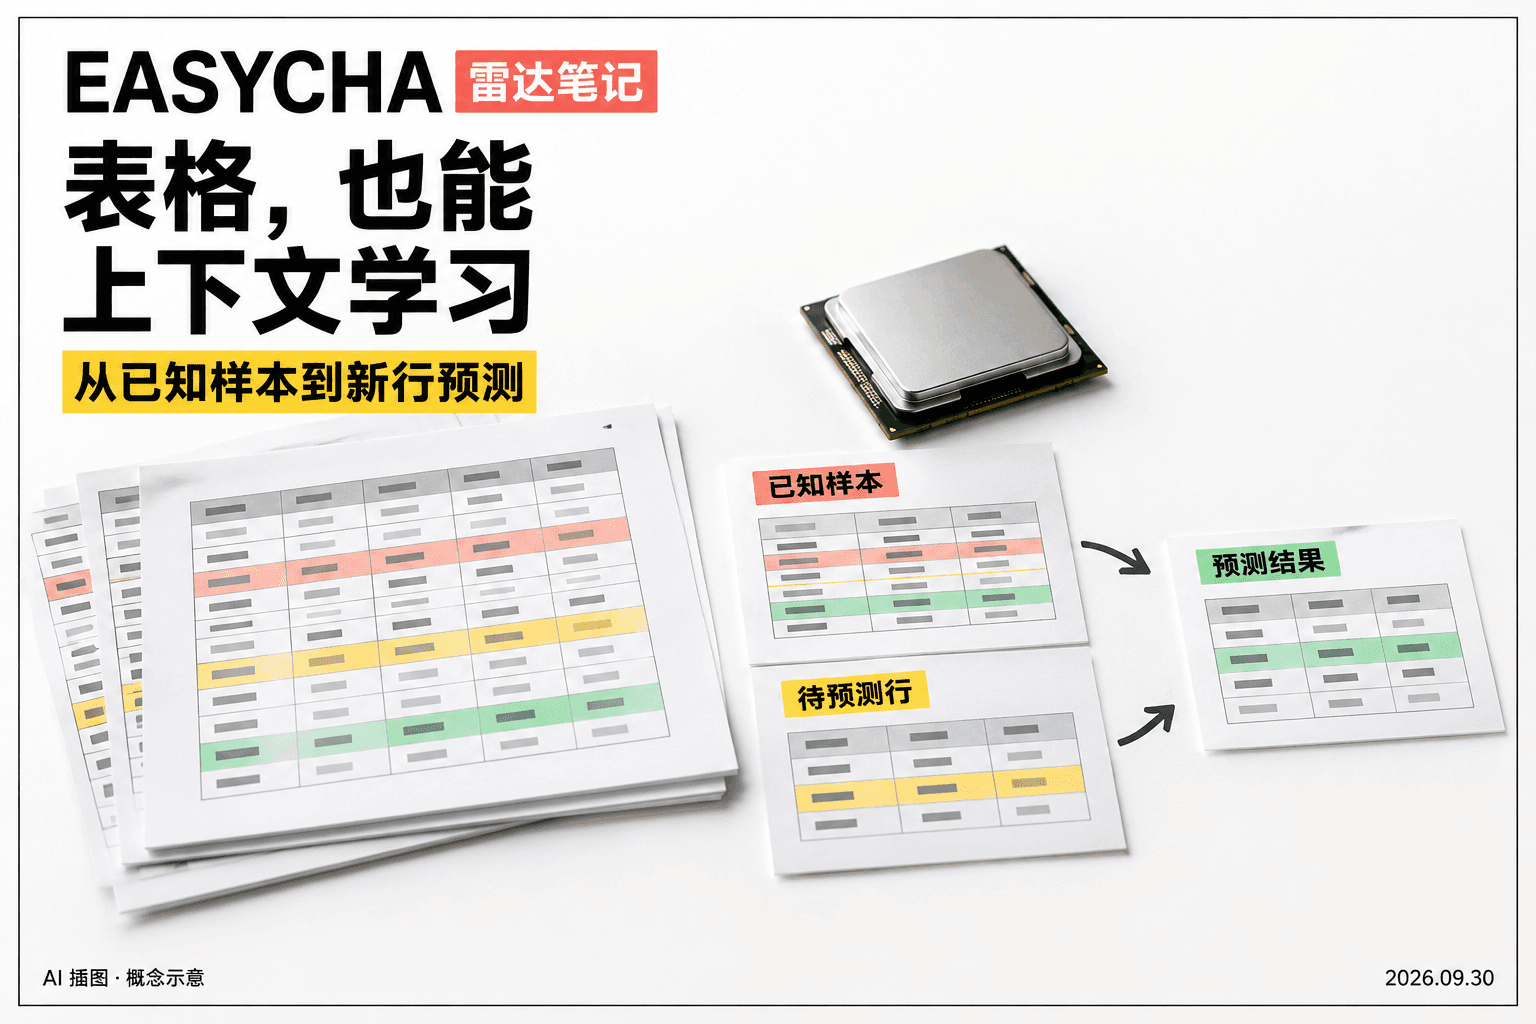
AI 的输入不只有对话和图片。客户记录、订单、传感器日志等结构化数据,也常需要模型判断类别或预测数值。NVIDIA 团队昨天在 Hugging Face 发布 Kumo Tabular,尝试把上下文学习带入这类任务:给模型一组带标签的表格行,再让它预测新行的结果。
官方发布了什么
根据团队原文,Kumo Tabular 是面向表格分类与回归的预训练基础模型,提供三种规模,参数量从约 2800 万到 2.15 亿。模型权重已公开,配套使用 structured-data-models 库,权重许可证为 OpenMDW 1.1。官方模型卡也给出了安装和分类推理示例。本文整理公开材料,Easycha 未独立运行该模型或复现其评测。
它与传统流程的区别,在于利用预训练学到的表格规律处理新任务。带标签的行充当上下文,待预测行提供特征;模型在前向计算中返回分类概率或回归结果,而不是每换一张表就从头更新模型权重。
这里的“无需训练”指使用新任务时的路径,并不是模型从未训练。官方说明,预训练完全使用人工生成的表格,覆盖缺失值、类别特征和复杂数值分布等情况;分类与回归分别训练。训练配方和数据生成器则在原文中列为后续将公开的内容。
为什么能重复利用上下文
Kumo Tabular 先处理单元格,再把每行压缩成表示,最后通过注意力机制关联已知标签的行与待预测行。原文强调,查询行只读取上下文,不读取其他查询行,因此一个样本的预测不应因为同批次还放了哪些查询样本而改变。上下文也不读取查询行,其键值缓存可以用于后续预测。
Easycha 分析:这对持续给新增记录打分的流程很有吸引力。固定一批经过检查的历史样本,可能减少反复处理相同上下文的开销。不过,实际缓存如何复用、占用多少显存、何时更新上下文,都要结合具体实现与业务数据验证,不能仅凭架构描述推导接口吞吐。
接入前先分清数据类型与任务
原文说明,模型直接处理数值与类别列;文本、图片和时间戳需要通过预处理方案转成特征。这不是让聊天模型阅读电子表格后自由回答问题,也不是现成的 OpenAI 兼容聊天接口。官方模型卡展示的是 Python 库与 CUDA 设备上的推理流程,应用若需要 HTTP 服务,还需自行组织数据校验、模型调用和响应格式。
单次前向计算直接覆盖最多十个类别,更多类别由库通过纠错输出编码扩展处理。因此,“一次前向”不能理解成任意任务、任意配置都只有一次模型调用;集成预测等设置也可能改变计算量。
性能信息怎样用
NVIDIA 团队报告了在 TabArena、BeyondArena、TALENT 和 ScoringBench 上的评测结果。它们分别关注不同任务与指标,不能把榜单名次直接换成自己业务中的准确率。原文还提醒,当表格远超训练范围,或查询数据与上下文的分布不同,准确性可能下降。
Easycha 建议:先保留一份真正未参与上下文构建的验证数据,与现有树模型或业务基线做同条件比较。涉及随时间变化的订单、客户行为时,可按时间划分样本,并检查特征是否意外包含预测时尚不可知的信息。
除了预测误差,还应记录概率是否可靠、推理耗时、显存占用,以及上下文样本变化后的稳定性。Kumo Tabular 提供了更快启动表格建模实验的新选择,但有价值的落地结论,仍来自清晰的目标、合适的数据划分与可重复的验证。以上接入建议为 Easycha 编辑分析。